閱讀自Practical Computing for biologists by Haddock Dunn


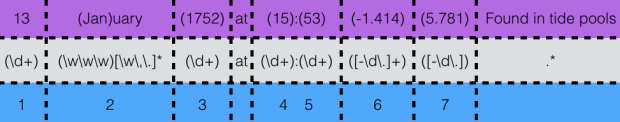
\3 \2 \. \1 \4 \5 \ 6 \7
閱讀自Practical Computing for biologists by Haddock Dunn


\3 \2 \. \1 \4 \5 \ 6 \7
原始論文:
Cole Trapnell,Adam Roberts,Loyal Goff,Geo Pertea,Daehwan Kim,David R Kelley,Harold Pimentel,Steven L Salzberg,John L Rinn& Lior Pachter. Differential gene and transcript expression analysis of RNA-seq experiments with TopHat and Cufflinks.Nature Protocols.7,562–578(2012)Doi:10.1038/nprot.2012.016
RNAseq的資料分析主要有兩個大目的:
而在分析步驟上,可以把它拆成三個分析流程:
本篇論文主要介紹用期開發的程式作為workflow,並且簡單介紹每個tool之間的異同。
所使用的工具和工作流程:
Read alignment with Tophat
Reads拼回去reference的步驟非常重要,他可以找出所有可能的insertion/deletion/indel,這些資訊可以讓我們了解辨識出相對於對照序列的polymorphism,另外,對不回去的reads,可能是新的protein-coding genes或是noncoding RNA。這邊拼回去的結果,也會影響之後如何去計算transcript abundance的數值。

Transcripts assembly with Cufflinks
為了要知道各種基因的表現量,我們必須知道各種reads所對應的isoforms transcripts,這邊就必須把Reads拼組成各種特定的transcipts,這步驟牽涉到如何辨別不同種transcripts variant ,所以最後產生transfrags來表達所有可能。
cufflinks會將一些low abundance的tansfrag當作是來自於immature transcripts而丟棄,這部分是要了解的。(或許這步驟可以思考一下!),有時候我們會將所有的bam pool在一起讓他找transcripts,但這種作法其實一方面增加電腦計算的loading,另一方面,則是會讓程式在計算isoform時增加很多變數,所以cuffmerge應映兒生,他可以把individual產出的transfrag merge在一起看!

Differeial Expression Analysis with Cuffdiff
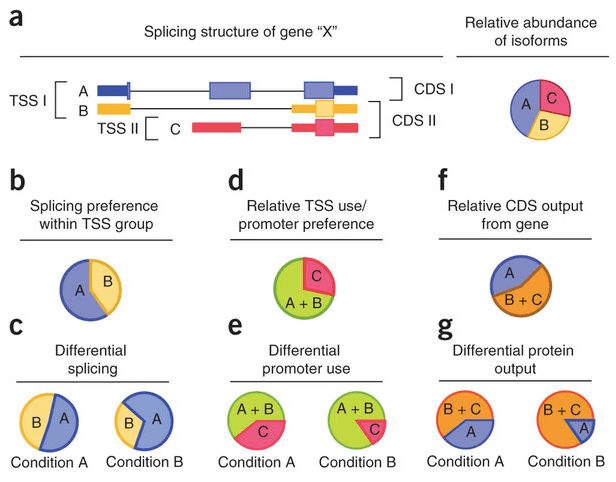
cuffdiff可以輸出好幾個檔案描述不同基因和transcripts的表現量差別和p value以及其名字和在基因體上的位置,另外,cuffdiff也可以把同一組基因裡面不同TSS的transcripts分組去計算他們之間比例的變化!
視覺化資料CummeRbound
cuffdiff提供基因和transcripts的表現量分析,且這些資料是以tab-delimited的方式輸出很方便後續的分析,而CummeRbound則是提供一個更容易操作的視覺化分析,可以將cuffdiff的計算結果做更細緻的分析。
替代工具:
有趣的相關論文:
Read-alignment
Transcript reconstruction
Quantification
Differential Expression
閱讀自Practical Computing for biologists by Haddock Dunn
Regular Expression是什麼呢?對於生物背景的人來說,一開始對於這名詞總是霧茫茫的。想要深入研究的話,可以看這篇文章 。簡單來說,Regular Expression(正規表達式)是用來標記某種特定文字pattern的符號表達方式,讓我們能用更強大的方式搜索文本並且修改,要注意的地方是不同程式之間所使用的Regular Expression會有一些差異,這邊想要介紹是Regex
Regular Expression在表達一個搜尋pattern時,主要由三類型符號組成:
威力強大的工具:搜尋+取代
|
搜尋字彙(character sets)
|
意思 |
|
\w
|
可代表文字、數字或是底標
|
|
\t
|
代表Tab符號
|
|
\s
|
代表空白鍵、Tab、和end of line
|
|
\r \n
|
代表end of line
|
|
\d
|
代表數字0-9
|
|
.
|
代表任何符號除了end of line
|
|
Anchor
|
意思
|
|
^
|
第一個符號
|
|
$
|
最後一個符號
|
|
Modifiers
|
意思
|
|
[ ]
|
客製化wildcard
|
|
{ }
|
創建一個array
|
|
( )
|
指定此內符號被置換
|
來看一下實際的例子

Onco-proteogenomic research 是結合genome和proteome的資訊來回答癌症研究的問題。
在生物的中心法則central dogma: DNA -> RNA -> Protein,越往下越直接影響到生物體的功能,但也越難研究,自從Mass Spectrometry的技術不斷精進,目前研究蛋白體學的武器比之前跑電泳的時代不同了,但研究蛋白體學的技術難度終究還是遠大於基因體學的技術,隨者定序資料越來越便宜,使用定序資料來幫助蛋白體學的研究是另一個蠻新穎的方式,目前RNA-seq可以很容易找出大量的unknown transcripts或是chimeric transcripts,但是不是真的存在,是很難單純用定序資料可以回答的,要是能使用Proteomic data來validation,那麼會非常有說服力。

Onco-proteogenomics研究有許多待克服的挑戰,以下簡單介紹和搭配各自的reference:
挑戰一:在癌症研究中,我們最在意的便是能否找到一些在癌症組織中基因、蛋白體的特異性改變(Tumor-specifci change in the proteome),像是:癌症是怎麼開始的(Tumor initiation)、癌症為何會惡化(Tumor progression)、癌細胞是如何對治療產生resistance(Adaptation to treatment),這過程中,研究者很容易會找到變異,但哪些是“passenger change”,哪些是“driven change”,背後要用什麼統計模型來解釋、如何處理多樣化的資料來源、資料如何呈現等等
挑戰二:想要用MS/MS來看癌症組織中某個蛋白質或是變異蛋白質的量,來確認從Genomic data analysis的結果,也會遇到“不一定看得到想看的,沒看到也不代表沒有”的難題,畢竟蛋白體在細胞中的量是動態的,而一些基因的變異所產生的mutated protein產量不多(基因變異不一定都造成蛋白質的量下降,像是P53 mutated會造成相反的效果)。
挑戰三:從genomic data建置成reference data base時所使用的six-frame translation會產生比較多的可能,但實際上可能產生突變的蛋白質約莫數百,且大部分都是passenger mutation,從統計來看可能會造成false discovery rate上升。
挑戰四:在proteogenomic 研究上有一個根本的問題,那便是如何將不同的資料結合,來闡述所有跟cancer-related phenotype的認知,這是非常困難的,但才是我們核心想知道的,到底病人怎樣才會回復健康。
挑戰五:目前評估某一個新的Onco-proteogenomic技術都是看其發現多少基因變異為主,這種思維很容易造成研究人員過度的追求找出新的mutation,但另一方面同時也是增加false discovery rate,造成一堆垃圾資料產生。
幾篇有趣的Onco-proteogenomic research paper:
Evans, V.C. et al. De novo derivation of proteomes from transcriptomes for transcript and protein identification. Nat. Methods 9, 1207–1211 (2012).
Li, H., Ruan, J. & Durbin, R. Mapping short DNA sequencing reads and calling variants using mapping quality scores. Genome Res. 18, 1851–1858 (2008).
Aquino, P.F. et al. Exploring the proteomic landscape of a gastric cancer biopsy with the Shotgun Imaging Analyzer. J. Proteome Res. 13, 314–320 (2014).
O’Rawe, J. et al. Low concordance of multiple variant-calling pipelines: practical implications for exome and genome sequencing. Genome Med. 5, 28 (2013).
閱讀自Practical Computing for biologists by Haddock Dunn
基本上,電腦的檔案都是一連串binarary numbers所組成的,另一種人類看得懂的格式則是文本形式(text files),而資料分析的起點便是如何處理這些text file,即使是我們引以為常的數字或是文字,電腦要呈現給我們看得懂,就必須要轉換格式,最常見的數字或是英文文字的格式便是American Standard Code for Information Interchange (ASCII)。
|
系統
|
推薦程式
|
|
MAC
|
|
|
Windows
|
|
|
Linux
|


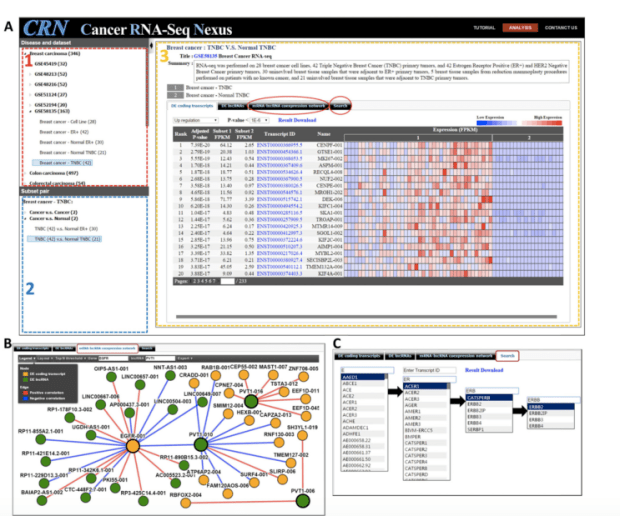
SevenBridges 是美國一家提供生資分析服務的公司,其團隊是從波士頓劍橋出來的,從其一開始合作的案子可以看出這家公司技術的印底子,他們有幫美國國家癌症研究中心建立RNA-seq分析的pipeline,加入視覺化的次世代資料分析,其將資料coverage analysis視覺化後,讓研究者更清楚知道哪部分的區段需要加強測序深度,也幫史丹佛的實驗室將其發表在Nature Biotechnology得分析工具HugeSeq,放在雲端平台上,提高其分析工具的使用性,解決這工具雖然好用,但是乏人問津的問題,一起開發single cell analysis的雲端技術
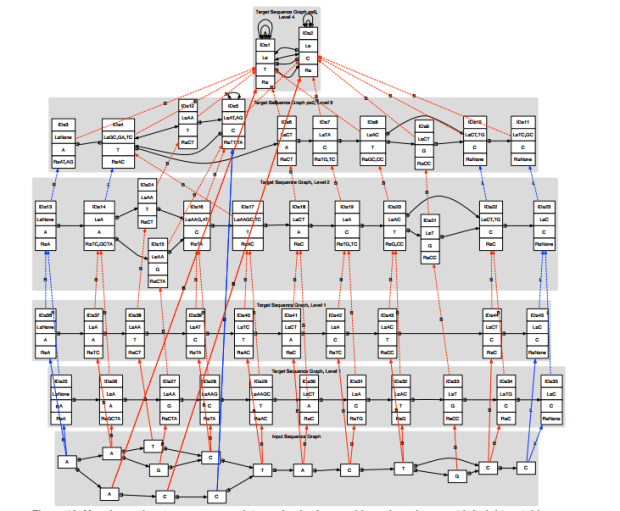
其也發展Graph Genome的方式來表現從70000人取得之定序資料,這樣的表示方式能凸顯族群裡的多樣性分布,相對於傳統的表現方式看出的是"平均"序列,更能人研究者取得更多的insights。

此公司特別之處還開發了一個開源工具Rabix,為了解決高通量資料分析時實驗不容易再現的問題,其是建立在Common Workflow Language上,方便統整所有使用的分析工具。


RNAseq的分析目前已經非常火紅的工具,相對於非模式生物的研究,要從頭把reference genome組起來,不如只接從transcriptome做起,在經費有限下是不錯的選擇,而如何最佳化這樣的分析是此論文的重點。
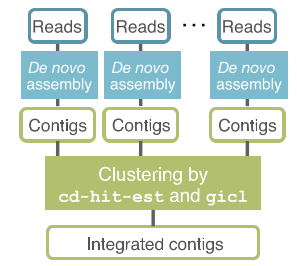
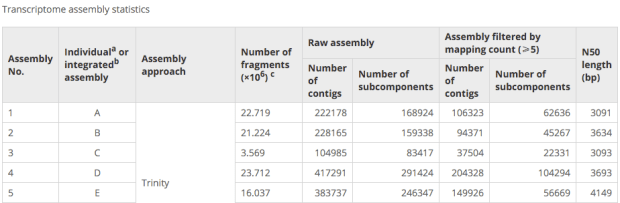
此篇論文主要有使用的分析軟體有:eggNOC、Trinity、SOAPdenovo-trans,其主要是分析蜥蜴胚胎(Madagascar ground gecko)三個發育時期的轉錄體,為了提高其在de novo assembled transcript sequences的完整性,其使用vertebrate one-to-one orthologs來作為reference。
其方法是基於調整RNA library、read lengths和insert sizes,加上使用有233個同源基因的對照組(one-to-one orthologs 來自29種species),最後使用CEGMA和BUSCO來執行completeness assessment,展現了此分析方式有效地提升的精準度。


Hara Y, Tatsumi K, Yoshida M, Kajikawa E, Kiyonari H, Kuraku S. (2015) Optimizing and benchmarking de novo transcriptome sequencing: from library preparation to assembly evaluation. BMC Genomics 16(1):977. [article]
在研究中國的基因技術生態系,當然是以華大基因為首,慢慢許多從華大基因出來的員工或是相關企業漸漸形成非常有活力的生態圈,蠻期待這部分的發展,希望台灣這方面也能壯大。
聚道科技GeneDock成立時間不到三年,主要是聚焦在基因定序資料的分析服務上,而非測序,其發展方便好用的雲端分析工具,建立數據分析pipeline,提供數據傳輸、儲存、融合、計算,方便使用者遠端上傳,並且看其分析的報告。有趣的是聚道科技的團隊來自於跨領域的組合,創辦人李夏戎從友盟的移動數據服務平台過來,原本擔任首席資料科學家,有帶領中科院團隊開發出pFind蛋白質注釋引擎,之後到阿里服務的王樂珩擔任CTO,在華大基因原擔任銷售副總裁的清林,甚至史丹佛生物資訊的教授作為合作夥伴。整個團隊非常堅強!
本來想註冊看看,但網站需要有註冊碼邀請才能註冊,想必是怕被佔用資源吧!小可惜!
參考訪問文章
在R裡面處理數據前處理時,dplyr 是非常強大的一個封包,其主要設計的理念有三個:
dplyr是由Hadley Wickham開發的,承接plyr的邏輯。語法上加入pipeline的概念,可以寫得非常精簡。
dplyr package 最重要的5個函數,其實就代表在資料前處理的普遍操作
當然新版本的dplyr其實會把輸入的檔案,轉換成tbl/tibble的格式,在資料呈現和內建的處理邏輯會有些不同,可能要小心,這邊寫其中一個用原生data.frame處理邏輯轉入到使用dplyr可能會遇到的。隨者使用tidyverse的包越來越多,會發現Hadley Wickham有一套很棒的計畫在逐漸把R原生的"較不直覺的"語法改進。
以下分別示範在dplyr中這幾個用法:
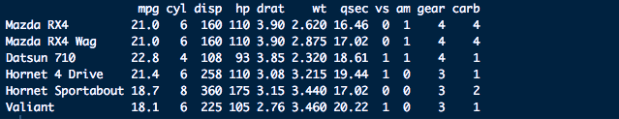
使用常用的mtcars資料集做示範:
select
data("mtcars")
mtcars %>% str()
這筆資料由Motor Trend US 雜誌所提供,總共有32部介於1973-74年出產的汽車其性能的資訊。

Select :挑選特定欄位進行分析,其利害的地方其實是這個函數的子函數:
select(mtcars, starts_with("m"))
select(mtcars, ends_with("b"))
select(mtcars, contains("ra"))
select(mtcars, matches("a"))
select(mtcars, disp, am)
Filter: 根據特定條件篩選資料
filter的使用就蠻直覺的,可以直接在後面接logical條件,且可以直接使用欄位名稱
filter(mtcars, cyl == 8) filter(mtcars, cyl < 6) # Multiple criteria filter(mtcars, cyl < 6 & vs == 1) filter(mtcars, cyl < 6 | vs == 1) # Multiple arguments are equivalent to and filter(mtcars, cyl < 6, vs == 1)
這邊整理filter可以使用的一些“logic”表示法
| Logic symbol | |
| == | 等於 |
| != | 不等於 |
| > | 大於 |
| < | 小於 |
| %in% | 包含於 |
| is.na() | 是否為NA值 |
Arrange: 將資料根據特定欄位來排序
預設是將數值由小到大排下去,假如有NA值的話,直接排最後,使用desc則變成由大到小,其本身支持multiple arrange
arrange(mtcars, cyl, disp) arrange(mtcars, desc(disp))
Mutate:由已有的行經過“處理(加減乘除等等)”,產生新的行
mutate(mtcars, displ_l = disp / 61.0237)
Summarise:總結行資料,形成單一值
summarise的函數,可能是需要多點練習,才會比較熟稔他的邏輯,其就是將資料進行sum, mean, median等等,原本r語言中,用來進階統計內建函數可以上場的時候。
summarise(mtcars, mean(disp)) summarise(group_by(mtcars, cyl), mean(disp)) summarise(group_by(mtcars, cyl), m = mean(disp), sd = sd(disp))
其實除了這五個基本函數外,dplyr封包中有很多進階的功能,可以進一步來活用!